

چهارشنبه 10 اردیبهشت 1404 – 11:00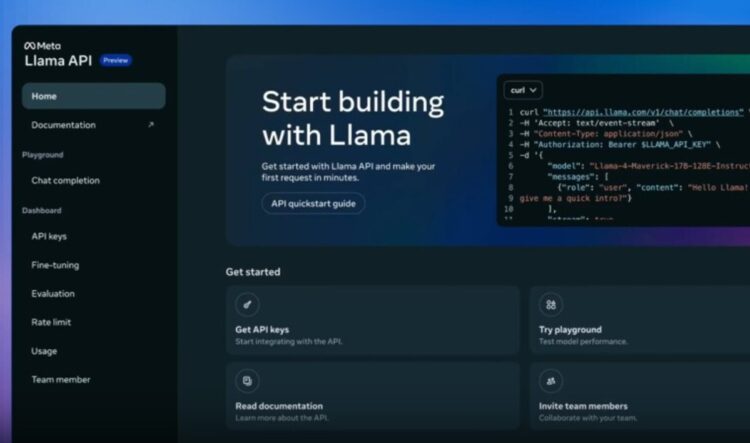 تکناک
شرکت متا برای دستیابی به سرعتهای استثنایی، با شرکتهای Cerebras و Groq وارد همکاری شده است. بنا بر اعلام شرکت Cerebras، مدل Llama 4 آنها میتواند با سرعتی تا ۱۸ برابر سریعتر از راهکارهای مبتنی بر GPU مانند NVIDIA، پاسخها را تولید کند. وبسایت تخصصی Artificial Analysis نیز تأیید کرده که مدل Llama 4 Scout با پشتیبانی از Cerebras موفق شده است به نرخ تولید بیش از ۲۶۰۰ توکن در ثانیه برسد؛ در حالی که ChatGPT تنها ۱۳۰ توکن/ثانیه و DeepSeek حدود ۲۵ توکن/ثانیه تولید میکنند.
توسعهدهندگان علاقهمند میتوانند با انتخاب مدل Cerebras در میان گزینههای ارائهشده توسط Llama API، از این سرعت بالا بهرهمند شوند. مدل Llama 4 Scout از طریق Groq نیز در دسترس است، اما در حال حاضر با سرعتی در حدود ۴۶۰ توکن در ثانیه عمل میکند؛ سرعتی که اگرچه ۶ برابر کُندتر از مدل Cerebras است، اما همچنان ۴ برابر سریعتر از سایر راهکارهای GPUمحور ارزیابی میشود.
برای مشاهده کامل مطب کلیک کنید